AI-Ready Infrastructure & Modern Data Center Integration
รู้ตัวเลข GPU กำลังไฟ และ Rack ที่ต้องใช้ ก่อนตัดสินใจซื้อเครื่องแรก
ซื้อ GPU ง่ายกว่าตอบคำถามว่าต้องใช้เท่าไหร่
กำลังไฟที่ GPU Server ตัวเดียวใช้ ต่อ Rack - สูงเป็นเท่าตัวของ Server ทั่วไป แอร์เดิมมักไม่พอเมื่อเพิ่มเป็นชุด
จำนวน GPU ที่งานทดลองส่วนใหญ่เริ่มได้ - แต่ "เดา" ไม่ได้ ต้องคำนวณจากโมเดลและจำนวนผู้ใช้จริง
ระยะเวลาติดตั้งทั่วไปนับจากอนุมัติ - งานที่ต้องปรับไฟหรือห้องใหม่อยู่ปลายสเกลนี้
พื้นที่ที่ต้องเผื่อตามขนาดงาน พร้อมน้ำหนักพื้นและระบบระบายความร้อนที่มาพร้อมกัน
จุดเริ่มของเราไม่ใช่เครื่อง แต่คือคำถาม "งานของคุณหนักแค่ไหน" - จากนั้นตัวเลขทุกอย่างคำนวณตามมาเอง
สิ่งที่เราทำ และสิ่งที่คุณได้รับกลับ
On-Premise GPU Cluster & AI Compute
ออกแบบ Compute Cluster จากโมเดลและจำนวนผู้ใช้จริง เลือก Hardware ระดับ Enterprise พร้อมคำนวณค่าไฟและความร้อนของทุกทางเลือกให้เทียบกันก่อนตัดสินใจ
- สเปกเซฟร์ 2-3 ทางเลือก พร้อมต้นทุน 3 ปีเทียบกัน
- แผนผังติดตั้ง Rack และสายเครือข่าย
- ติดตั้ง ทดสอบ benchmark และส่งมอบพร้อม Runbook
Modern Data Center & High-Density Cooling
ประเมินและยกระดับห้อง Server ให้รองรับ Rack กำลังสูงจาก GPU Server ครอบคลุมไฟฟ้า PDU, UPS, ระบบทำความเย็น และน้ำหนักโครงสร้างอาคาร
- รายงานผลวัดห้องจริง: ไฟ ความร้อน น้ำหนัก พร้อมระยะเผื่อ
- แผนยกระดับเป็นขั้นตอนตามงบที่มี
- ตรวจรับพร้อมเอกสารมาตรฐานสำหรับทีมอาคาร
Hybrid Cloud & High-Performance Network
เชื่อม On-Premise กับ AWS/Azure/GCP ด้วยลิงก์ที่เผื่อปริมาณจริงของงาน Big Data ไม่ใช่แค่ "เน็ตเร็ว" - พร้อมแผนสำรองเมื่อลิงก์หลักล่ม
- โทโพโลยีเครือข่ายพร้อมตัวเลข bandwidth ที่ต้องการจริง
- การเชื่อมต่อและทดสอบ throughput ตามแผน
- แผน failover และขั้นตอนแก้ไขเมื่อลิงก์มีปัญหา
จากโจทย์งานของคุณ สู่ Rack จริง - ทีละขั้น
ทุกโครงการเดินกระบวนการเดียวกัน: ไม่มีขั้นตอนไหนเดา
ตัวอย่างวิธีคิด: จากงาน 1 งาน สู่ Rack ที่ต้องจ่าย
สามกรณีที่พบบ่อย - ตัวเลขเป็นช่วงตัวอย่างเพื่อสาธิตวิธีคำนวณ ของจริงคำนวณจาก Workload ของคุณใน Site Survey
| โจทย์งาน | GPU ที่ต้องใช้ | กำลังไฟต่อ Rack | ความร้อนที่ต้องระบาย | พื้นที่ Rack |
|---|---|---|---|---|
| ทดลอง RAG ภายใน (ทีม 10-20 คน) | 1-2 ตัว ระดับ 24GB VRAM | ราว 2-4 kW | ต่อยอดแอร์เดิมได้ | ครึ่ง Rack |
| Inference ให้ทั้งองค์กร (100-300 คน) | 2-4 ตัว ระดับ 80GB+ | ราว 6-12 kW | ต้องวางแผน airflow ใหม่ | 1-2 Rack |
| Fine-tune / Training ต่อเนื่อง | 4-8+ ตัว + โครงข่ายความเร็วสูง | ราว 15-30 kW | พิจารณาระบายความร้อนแบบพิเศษ | 2+ Rack + พื้นที่เสริม |
จุดที่คนมักพลาด: ตัวเลขที่แพงที่สุดไม่ใช่ตัว GPU แต่คือค่าไฟและระบบระบายความร้อนตลอดอายุการใช้งาน - ทั้งสองอย่างนี้กำหนดตั้งแต่ขั้นออกแบบ ย้อนหลังไม่ได้
คำถามที่ผู้ตัดสินใจถามก่อนตัดงบ
งบเริ่มต้นสำหรับ GPU Server อยู่ระดับไหน?
ควรเลือก On-Premise หรือ Cloud?
ห้อง Server เดิมรองรับ GPU เพิ่มได้ไหม?
ติดตั้งนานแค่ไหน และหลังส่งมอบใครดูแล?
บทความที่เกี่ยวข้อง
สมรภูมิฮาร์ดแวร์ 2026: เมื่อยักษ์ใหญ่เปิดศึก Agentic AI, Chiplet Architecture และ 18A
NVIDIA Vera Rubin สร้าง AI Factory แบบ Rack-scale, Apple M5 ฝัง Neural Accelerator ทุก GPU C...
อ่านต่อ →
เทคนิค Quantization สำหรับโมเดลเล็ก (Small Language Models / SLMs)
คู่มือเชิงลึกสำหรับ quantize โมเดล 0.5B-7B: PTQ vs QAT, AWQ/GPTQ/NF4, GGUF Q4/Q5 สำหรับ Edge...
อ่านต่อ →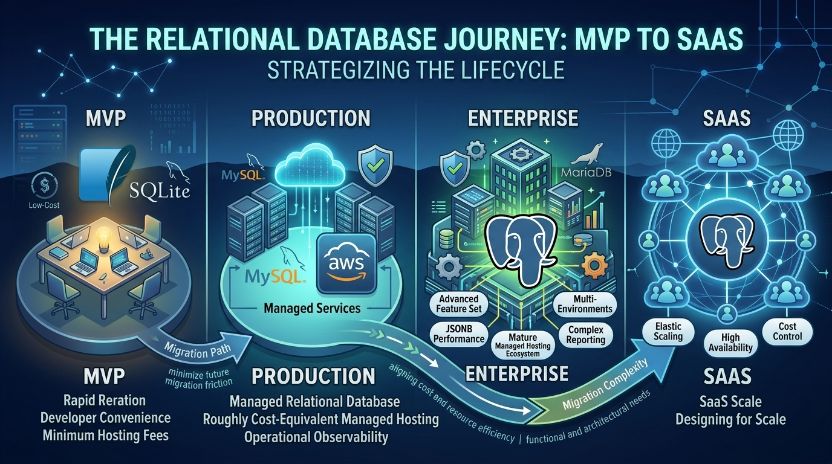
เลือก Database อย่างไรไม่ให้เสียใจ: คู่มือ SQLite, MySQL, MariaDB และ PostgreSQL จาก MVP ถึง...
Database ที่ถูกที่สุดในวันแรก อาจแพงที่สุดในปีที่สาม - สรุป research ฉบับปฏิบัติ: ค่า RDS ที...
อ่านต่อ →ก่อนตัดงบซื้อเครื่อง ให้เราวัดห้องจริงก่อน
Site Survey โดยวิศวกร ไม่มีค่าใช้จ่าย ไม่ผูกมัด - ได้รายงานกำลังไฟ ความร้อน และสเปกที่ต้องใช้จริง ตอบกลับภายใน 1 วันทำการ