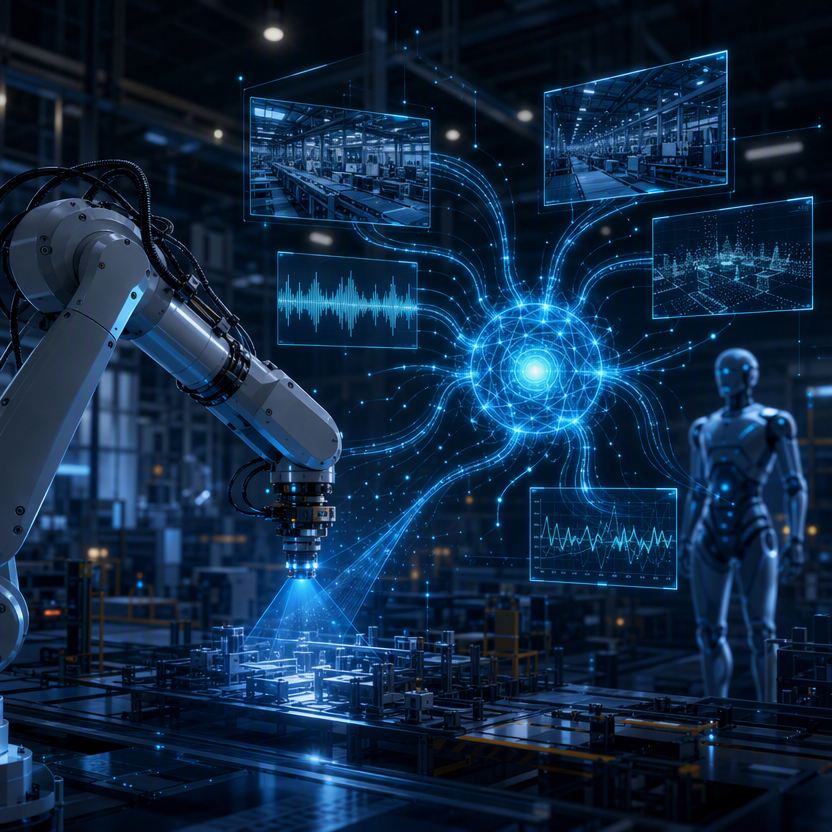
ปี 2026 เป็นช่วงที่ปัญญาประดิษฐ์กำลังก้าวข้ามข้อจำกัดของการเป็นเพียงระบบสนทนาบนหน้าจอ การเปลี่ยนแปลงสำคัญเกิดจากเทคโนโลยีสองกลุ่มที่กำลังบรรจบกัน ได้แก่ Multimodal AI ซึ่งทำให้ AI เข้าใจข้อมูลหลายรูปแบบพร้อมกัน และ Physical AI หรือ Embodied AI ซึ่งนำความสามารถดังกล่าวไปควบคุมหุ่นยนต์ ยานยนต์ และเครื่องจักรในโลกจริง
หาก Generative AI ทำให้เครื่องจักรสามารถสร้างเนื้อหาได้ และ Agentic AI ทำให้ AI วางแผนและเรียกใช้เครื่องมือได้ การมาถึงของ Physical AI คือขั้นต่อไปที่ทำให้ AI สามารถ รับรู้ ตัดสินใจ และลงมือปฏิบัติในสภาพแวดล้อมจริง
Multimodal AI ไม่ได้หยุดอยู่ที่ "ดูภาพแล้วตอบคำถาม"
Multimodal AI รุ่นแรกมักประกอบด้วยโมเดลภาษาที่เชื่อมต่อกับระบบวิเคราะห์ภาพ กล่าวอย่างง่ายคือ นำ Vision Encoder มาต่อเข้ากับ Large Language Model เพื่อให้โมเดลรับภาพและตอบกลับเป็นข้อความได้
แต่โมเดลชั้นนำในปี 2026 กำลังเปลี่ยนไปสู่แนวทาง Native Multimodal Architecture ซึ่งออกแบบให้ข้อมูลหลายรูปแบบเป็นส่วนหนึ่งของกระบวนการเรียนรู้ตั้งแต่ต้น โมเดลจึงสามารถเชื่อมโยงข้อความ ภาพ วิดีโอ เสียง และข้อมูลจากเซ็นเซอร์ได้อย่างเป็นธรรมชาติมากขึ้น
ความสามารถที่เห็นได้ชัด ได้แก่
- วิเคราะห์วิดีโอขนาดยาวและตอบคำถามเกี่ยวกับเหตุการณ์ตามลำดับเวลา
- อ่านแผนผัง ตาราง กราฟ เอกสารสแกน และภาพหน้าจอของระบบงาน
- ทำความเข้าใจโค้ดหรือข้อความแสดงข้อผิดพลาดจาก Screenshot
- วิเคราะห์น้ำเสียง เนื้อหาการสนทนา และภาพประกอบร่วมกัน
- สร้างวิดีโอพร้อมเสียงที่สัมพันธ์กับเหตุการณ์ในฉาก
- ใช้ภาพ เสียง และข้อมูลจากเซ็นเซอร์ประกอบการวางแผนและเรียกใช้เครื่องมือ
หัวใจสำคัญจึงไม่ใช่จำนวนประเภทข้อมูลที่โมเดลรองรับ แต่เป็นความสามารถในการ เชื่อมความหมายข้าม Modalities เช่น การเชื่อมภาพชิ้นส่วนที่ชำรุดกับข้อมูลเซ็นเซอร์ คู่มือซ่อมบำรุง และประวัติการแจ้งเตือนในระบบ ERP
จาก Multimodal สู่ Agentic Multimodal
เมื่อ Multimodal AI ทำงานร่วมกับ Agentic AI ระบบจะไม่ได้เพียงวิเคราะห์ข้อมูล แต่สามารถตัดสินใจว่าจะดำเนินการอะไรต่อ ตัวอย่างเช่น ระบบในโรงงานอาจทำงานตามลำดับดังนี้
- วิเคราะห์ภาพวิดีโอจากสายการผลิต
- ตรวจพบความผิดปกติของชิ้นส่วน
- อ่านค่าอุณหภูมิและแรงสั่นสะเทือนจากเซ็นเซอร์
- ตรวจสอบประวัติของเครื่องจักรจากระบบบำรุงรักษา
- ค้นหาคู่มือและวิธีแก้ไขที่เกี่ยวข้อง
- สร้างใบงานซ่อมใน ERP
- แจ้งเตือนวิศวกรและเสนอช่วงเวลาหยุดเครื่อง
นี่คือความแตกต่างระหว่าง "AI ที่มองเห็น" กับ "AI ที่มองเห็น เข้าใจ และดำเนินการต่อ" ซึ่งเป็นเหตุผลที่ Multimodal AI เริ่มมีบทบาทในงานที่ข้อมูลจริงไม่ได้อยู่ในรูปข้อความเพียงอย่างเดียว
การประยุกต์ใช้ในองค์กร
Multimodal AI เหมาะกับกระบวนการที่ต้องนำข้อมูลหลายรูปแบบมาประกอบการตัดสินใจ
| อุตสาหกรรม | ตัวอย่างการใช้งาน |
|---|---|
| โรงงาน | ตรวจสอบคุณภาพสินค้า วิเคราะห์วิดีโอและข้อมูลเซ็นเซอร์ คาดการณ์การซ่อมบำรุง |
| การแพทย์ | เชื่อมข้อมูลภาพทางการแพทย์ เวชระเบียน เสียงสนทนา และข้อมูลจากอุปกรณ์ติดตาม |
| กฎหมายและการเงิน | อ่านเอกสารสแกน ตาราง ลายเซ็น หลักฐานภาพ และไฟล์เสียง |
| บริการลูกค้า | วิเคราะห์เสียง น้ำเสียง ข้อความ Screenshot และประวัติการใช้บริการร่วมกัน |
| ค้าปลีก | ตรวจสอบชั้นวางสินค้า วิเคราะห์พฤติกรรมลูกค้า และเชื่อมกับข้อมูลสต็อก |
| ประกันภัย | วิเคราะห์ภาพความเสียหาย เอกสารคำร้อง และข้อมูลกรมธรรม์ |
ในเชิงธุรกิจ ประโยชน์ไม่ได้มาจากความสามารถของโมเดลเพียงอย่างเดียว แต่เกิดจากการลดขั้นตอนที่มนุษย์ต้องเปิดข้อมูลจากหลายระบบแล้วนำมาประกอบกันเอง
Physical AI คืออะไร
Physical AI หรือ Embodied AI คือระบบ AI ที่มีความสามารถสี่ส่วนต่อเนื่องกัน ได้แก่
- Perceive: รับรู้โลกผ่านกล้อง ไมโครโฟน LiDAR เรดาร์ และเซ็นเซอร์
- Understand: เข้าใจวัตถุ พื้นที่ เหตุการณ์ ความสัมพันธ์ และข้อจำกัดทางกายภาพ
- Plan: วางแผนลำดับการเคลื่อนไหวหรือการทำงานให้บรรลุเป้าหมาย
- Act: ควบคุมหุ่นยนต์ ยานยนต์ โดรน หรือเครื่องจักรให้ลงมือปฏิบัติ
Physical AI จึงไม่ได้หมายถึงหุ่นยนต์มนุษย์หรือ Humanoid เท่านั้น แต่ครอบคลุมหุ่นยนต์แขนกล หุ่นยนต์เคลื่อนที่อัตโนมัติ ระบบคลังสินค้า รถยนต์ไร้คนขับ โดรน และเครื่องจักรอุตสาหกรรมที่สามารถปรับตัวตามสภาพแวดล้อมได้
Deloitte ระบุว่าคลังสินค้า โลจิสติกส์ และซัพพลายเชนเป็นพื้นที่พิสูจน์การใช้งานที่สำคัญ แม้การนำ Humanoid มาใช้ในวงกว้างยังต้องใช้เวลาอีกหลายปี (Deloitte)
World Foundation Model: ให้ AI เรียนรู้ว่าโลกทำงานอย่างไร
ข้อจำกัดสำคัญของหุ่นยนต์แบบเดิมคือ ต้องถูกโปรแกรมให้ทำงานภายใต้เงื่อนไขที่ค่อนข้างแน่นอน เมื่อวัตถุถูกย้าย ตำแหน่งเปลี่ยน หรือเกิดเหตุการณ์ที่ไม่เคยพบมาก่อน ระบบอาจไม่สามารถรับมือได้
World Foundation Model เข้ามาช่วยให้ AI สร้างแบบจำลองของโลกทางกายภาพ คาดการณ์สิ่งที่จะเกิดขึ้น และประเมินผลของการกระทำก่อนสั่งให้หุ่นยนต์ลงมือจริง กลางปี 2026 NVIDIA เปิดตัว Cosmos 3 ซึ่งรวมความสามารถด้านการให้เหตุผลจากภาพ การสร้างโลกจำลอง และการสร้าง Action ไว้ใน Foundation Model เดียว โดยรองรับข้อมูลอย่างข้อความ ภาพ วิดีโอ เสียงแวดล้อม และการกระทำ (NVIDIA)
ตัวอย่างเช่น ก่อนให้แขนกลหยิบแก้วที่อยู่ใกล้ขอบโต๊ะ โมเดลสามารถประเมินได้ว่า
- วัตถุอยู่ห่างจากแขนกลเท่าใด
- ต้องใช้แรงจับระดับใด
- เส้นทางการเคลื่อนไหวจะชนสิ่งกีดขวางหรือไม่
- หากจับผิดตำแหน่ง วัตถุมีโอกาสล้มหรือแตกอย่างไร
- ควรเลือก Action ใดที่มีความปลอดภัยมากที่สุด
ความสามารถนี้ทำให้ AI เริ่มมี "ความเข้าใจทางกายภาพ" มากกว่าการจดจำวัตถุจากภาพเพียงอย่างเดียว
Synthetic Data และ Simulation คือหัวใจของการฝึก
การรวบรวมข้อมูลจากโลกจริงมีต้นทุนสูง ใช้เวลานาน และบางเหตุการณ์ไม่สามารถทดลองซ้ำได้อย่างปลอดภัย เช่น การชน อุบัติเหตุ หรือการทำงานผิดพลาดใกล้มนุษย์ องค์กรจึงใช้โลกจำลองและ Synthetic Data เพื่อสร้างสถานการณ์จำนวนมาก เช่น
- แสงและมุมกล้องหลายรูปแบบ
- พื้นผิวและน้ำหนักของวัตถุที่แตกต่างกัน
- เหตุการณ์ผิดปกติที่พบได้ยาก
- พื้นที่ทำงานที่มีสิ่งกีดขวาง
- การทำงานร่วมกันระหว่างมนุษย์กับหุ่นยนต์
Cosmos 3 สามารถสร้างลำดับวิดีโอที่มีความเป็นไปได้ทางกายภาพ เพื่อช่วยจำลองเหตุการณ์และกรณีขอบที่รวบรวมจากโลกจริงได้ยาก (NVIDIA Blog)
Simulation ช่วยลดจำนวนรอบการทดลองบนฮาร์ดแวร์จริงและเร่งการพัฒนาได้ แต่ไม่ควรสรุปว่าจะลดระยะเวลาฝึกจาก "หลายเดือนเหลือไม่กี่วัน" ได้กับทุกกรณี ผลลัพธ์ขึ้นอยู่กับคุณภาพของแบบจำลอง ความแตกต่างระหว่างโลกจำลองกับโลกจริง และความซับซ้อนของงาน
Cross-Embodiment: ความรู้เดียว ใช้กับหุ่นยนต์หลายประเภท
อีกแนวโน้มสำคัญคือ Cross-Embodiment หรือความสามารถในการถ่ายทอดความรู้ระหว่างหุ่นยนต์ต่างรูปแบบ
ในอดีต โมเดลที่ฝึกกับแขนกลชนิดหนึ่งมักไม่สามารถนำไปใช้กับแขนกลหรือหุ่นยนต์อีกประเภทได้ทันที เพราะโครงสร้าง จำนวนข้อต่อ เซ็นเซอร์ และระบบควบคุมแตกต่างกัน
แนวทางใหม่พยายามสร้าง Representation กลางของงานและการกระทำ เช่น "หยิบวัตถุ วางบนสายพาน และหลีกเลี่ยงมนุษย์" แล้วแปลงแผนดังกล่าวให้เหมาะกับร่างกายของหุ่นยนต์แต่ละประเภท หากทำได้สำเร็จ จะลดการฝึกใหม่ทั้งหมดเมื่อองค์กรเปลี่ยนฮาร์ดแวร์
Reality Check: โลกจริงไม่เป็นระเบียบเหมือนห้องทดลอง
แม้ Physical AI จะพัฒนาเร็ว แต่การสาธิตที่น่าประทับใจไม่ได้หมายความว่าระบบพร้อมทำงานตลอด 24 ชั่วโมงในโรงงานจริง ความท้าทายสำคัญประกอบด้วย
- Sim-to-real gap: พฤติกรรมในโลกจำลองอาจไม่ตรงกับโลกจริง
- Long-tail events: ระบบอาจพบเหตุการณ์ที่ไม่เคยอยู่ในชุดข้อมูลฝึก
- Reliability: ความแม่นยำ 95% อาจยังไม่เพียงพอกับงานที่ทำซ้ำหลายพันครั้งต่อวัน
- Safety: การตัดสินใจผิดของ AI อาจทำให้ทรัพย์สินเสียหายหรือเป็นอันตรายต่อมนุษย์
- Latency: การรับรู้และตัดสินใจต้องเกิดเร็วพอสำหรับการควบคุมเครื่องจักร
- Integration: ต้องเชื่อม AI เข้ากับ PLC, MES, WMS, ERP และระบบความปลอดภัยเดิม
- Cybersecurity: หุ่นยนต์ที่เชื่อมต่อเครือข่ายกลายเป็นจุดเสี่ยงต่อระบบปฏิบัติการจริง
- Economics: ต้องรวมค่าฮาร์ดแวร์ เซ็นเซอร์ พลังงาน การบำรุงรักษา และเวลาหยุดระบบไว้ใน ROI
สำหรับงานที่เกี่ยวข้องกับความปลอดภัย ควรมีระบบกำหนดพื้นที่ทำงาน การจำกัดแรงและความเร็ว Emergency stop การบันทึกเหตุการณ์ และกลไกให้มนุษย์รับช่วงควบคุมได้เสมอ
องค์กรควรเริ่มต้นอย่างไร
องค์กรไม่ควรเริ่มจากคำถามว่า "จะซื้อ Humanoid รุ่นใด" แต่ควรเริ่มจากกระบวนการที่มีปัญหาและวัดผลได้
- เลือกงานที่ทำซ้ำสูง สภาพแวดล้อมค่อนข้างควบคุมได้ และมีความเสี่ยงต่อพนักงาน
- เริ่มจาก Multimodal Copilot ที่ช่วยตรวจสอบและแนะนำก่อนให้ AI ลงมือเอง
- ทดสอบในพื้นที่จำกัดและกำหนดขอบเขตการทำงานอย่างชัดเจน
- เชื่อมต่อ ERP หรือระบบโรงงานผ่าน API ที่มีสิทธิ์และ Audit log
- วัดผลด้วยต้นทุนต่อภารกิจ อัตราทำงานสำเร็จ เวลาหยุดเครื่อง และเหตุการณ์ด้านความปลอดภัย
- ขยายระดับความเป็นอัตโนมัติเฉพาะเมื่อระบบผ่านเกณฑ์ Reliability และ Safety
บทสรุป
Multimodal AI ทำให้ AI มี "ตาและหู" ขณะที่ Agentic AI เพิ่มความสามารถในการวางแผน ส่วน Physical AI ทำให้ระบบมี "ร่างกาย" สำหรับลงมือทำในโลกจริง
แต่จุดเปลี่ยนที่แท้จริงของปี 2026 ไม่ได้อยู่ที่การมีหุ่นยนต์ที่ดูคล้ายมนุษย์ แต่อยู่ที่การเชื่อม โมเดลหลายรูปแบบ World Model, Simulation, Sensor, ระบบควบคุม และข้อมูลขององค์กร ให้กลายเป็นระบบที่ทำงานได้อย่างปลอดภัยและคุ้มค่า
องค์กรที่จะได้ประโยชน์ก่อนจึงไม่จำเป็นต้องเป็นองค์กรที่ซื้อหุ่นยนต์เร็วที่สุด แต่เป็นองค์กรที่เลือกกระบวนการเหมาะสม มีข้อมูลพร้อม เชื่อมระบบเดิมได้ และสามารถพิสูจน์ ROI ต่อภารกิจในโลกจริงได้
ทีม Devsign ออกแบบระบบ AI สำหรับโรงงานและงานอุตสาหกรรม ตั้งแต่เลือก Use case ออกแบบ Data pipeline เชื่อมระบบเดิม จนถึงวัดผลต่อภารกิจจริง