เปรียบเทียบสถาปัตยกรรมความปลอดภัย AI Agent 4 ค่าย: Meta Muse (Secure VM + Sentinel Agent Out-of-Band), OpenAI (Model Guardrails), Anthropic (User-Hosted Sandbox), Google (Workspace Permission) - วิเคราะห์การป้องกัน Indirect Prompt Injection, การจัดการ Credentials และการควบคุมแบบเรียลไทม์
การเปลี่ยนผ่านจาก Large Language Model (LLM) ไปสู่ Autonomous AI Agent ที่มีสิทธิ์สั่งการแอปพลิเคชัน โอนเงิน หรือเข้าถึงข้อมูลส่วนบุคคล นำมาซึ่งความเสี่ยงทางไซเบอร์รูปแบบใหม่อย่างยิ่งยวด โดยเฉพาะภัยคุกคามประเภท Indirect Prompt Injection (การซ่อนคำสั่งอันตรายไว้บนหน้าเว็บหรืออีเมลเพื่อหลอกให้ AI ทำงานผิดพลาด)
Meta Muse ได้ออกแบบสถาปัตยกรรมความปลอดภัยเพื่อรับมือกับปัญหานี้อย่างเป็นระบบ เมื่อนำไปเปรียบเทียบกับแนวทางรักษาความปลอดภัยของ AI Agent จากค่ายเทคโนโลยีชั้นนำอื่น ๆ จะเห็นความแตกต่างเชิงโครงสร้างอย่างชัดเจน
1. Meta Muse: สถาปัตยกรรม Isolation & Out-of-Band Gatekeeper
Meta Muse แก้ปัญหาความปลอดภัยโดยใช้วิธี Hardware/OS-level Isolation ร่วมกับ External Monitoring Agent
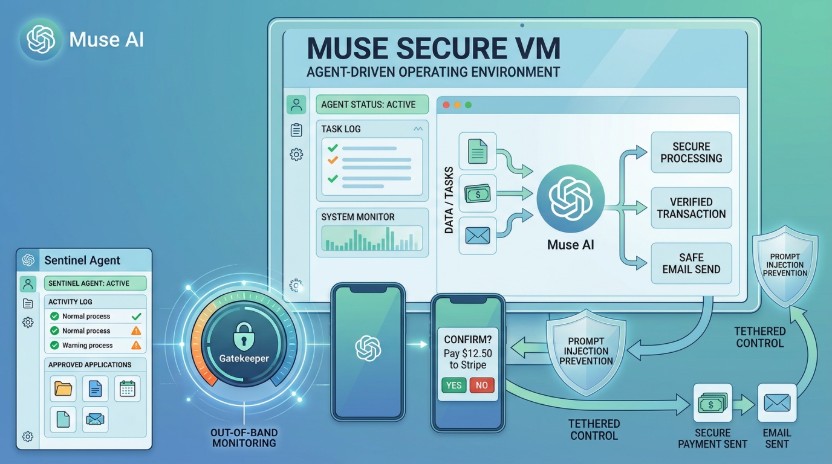
- Muse Secure VM: ผู้ใช้แต่ละคนได้รับการแยกสภาพแวดล้อมการทำงานบน Linux Cloud Virtual Machine เฉพาะบุคคล เอเจนต์และเบราว์เซอร์ Headless Chromium ทำงานอยู่ภายใน Sandbox นี้อย่างสมบูรณ์ หากโดนโจมตีด้วย Malicious Script หรือ Prompt Injection ความเสียหายจะถูกจำกัดอยู่แค่ภายใน VM นั้น ไม่สามารถเข้าถึง OS หรือไฟล์ในเครื่องจริงของผู้ใช้ได้
- Sentinel Agent (Out-of-Band Security Layer): เป็นโปรเซสเฝ้าระวังที่รันอยู่บน Host ภายนอก VM ของผู้ใช้ (Outside the Blast Radius) ไม่ได้พึ่งพาตรรกะของ LLM เพียงอย่างเดียว แต่ดักจับ Traffic และ Network I/O ในระดับระบบปฏิบัติการ หาก Muse พยายามส่งข้อมูลออก ดำเนินการชำระเงิน หรือทำธุรกรรมเสี่ยง Sentinel จะทำหน้าที่เป็น Circuit Breaker ระงับภารกิจทันทีและส่งสัญญาณขออนุมัติมายังโทรศัพท์มือถือของผู้ใช้
2. การเปรียบเทียบกับแนวทางของค่ายอื่น
A. OpenAI (Computer-Using Agent / Operator Approach)
- แนวทาง: อาศัย Model-Level Guardrails และ In-Context Monitoring เป็นหลัก
- จุดแข็ง: เน้นการฝึกฝนโมเดล (RLHF) ให้ปฏิเสธคำสั่งอันตรายและจดจำรูปแบบ Prompt Injection ได้ดี
- จุดอ่อนเมื่อเทียบกับ Muse: การพึ่งพาความปลอดภัยไว้ที่ตัวโมเดลเอง (In-Band Safety) มีความเสี่ยงสูงกว่า เพราะหากตกเป็นเหยื่อของการโจมตีเชิงตรรกะแบบขั้นสูง (Jailbreak) โมเดลอาจถูกหลอกให้อนุมัติการกระทำอันตรายได้ ต่างจาก Meta Muse ที่มี Sentinel Agent คอยตรวจจับสิทธิ์จากภายนอกโมเดลอีกชั้นหนึ่ง
B. Anthropic (Computer Use / Claude API Integration)
- แนวทาง: อาศัย User-Hosted Sandbox และ Strict Permission Scoping
- จุดแข็ง: ให้ความสำคัญกับนโยบาย Human-in-the-loop ที่เข้มงวด นักพัฒนาต้องเป็นผู้กำหนดขอบเขต API Key และจำกัดสิทธิ์ของเบราว์เซอร์/เครื่องเสมือนเอง
- จุดอ่อนเมื่อเทียบกับ Muse: โครงสร้างความปลอดภัยขึ้นอยู่กับการตั้งค่าของระบบปายทางหรือผู้ใช้งาน (Self-Managed Sandbox) ขณะที่ Meta Muse จัดสรร Secure VM + Sentinel เป็นโครงสร้างพื้นฐานสำเร็จรูปจากฝั่งผู้ให้บริการ (Managed Infrastructure)
C. Google (Gemini Ecosystem Integration)
- แนวทาง: อาศัย Workspace Permission Model และ Confidential Computing
- จุดแข็ง: ใช้ระบบสิทธิ์เดิมของ Google Workspace (OAuth 2.0 / Fine-grained Scopes) ในการจำกัดการเข้าถึงข้อมูล
- จุดอ่อนเมื่อเทียบกับ Muse: การปฏิบัติงานข้ามแพลตฟอร์มส่วนใหญ่อาศัย API Integrations ซึ่งจำกัดการโต้ตอบกับเว็บไซต์ทั่วไปที่ไม่มี API ขณะที่ Muse ใช้ Headless Chromium บน Secure VM โต้ตอบกับเว็บอินเทอร์เฟซได้เสมือนมนุษย์ โดยมี Sentinel คุมขอบเขตการกรอกข้อมูล
3. ตารางสรุปเปรียบเทียบสถาปัตยกรรมความปลอดภัย
| มิติความปลอดภัย | Meta Muse | OpenAI (Operator) | Anthropic (Computer Use) | Google Gemini Agents |
|---|---|---|---|---|
| ระดับการแยกส่วน (Isolation) | OS-Level Cloud VM เฉพาะบุคคล | Virtual Container / Web Sandbox | User/Developer-managed Sandbox | Workspace Permission Scopes |
| ตัวตรวจจับภัย (Gatekeeper) | Sentinel Agent (External Out-of-Band) | Model Internal Guardrails | API Boundary + Human-in-the-loop | IAM Policies + OAuth Scopes |
| การป้องกัน Prompt Injection | กักบริเวณใน VM + ดักจับการส่งข้อมูลภายนอก | เทรนโมเดลให้ปฏิเสธคำสั่งซ่อน | จำกัดสิทธิ์การสั่งการ OS / API | กรองอินพุตผ่าน Safety Filters |
| ข้อมูลการเงิน/รหัสผ่าน | Ephemeral Credit Cards (Link by Stripe) + Secure Credentials Store | Secure Vault / API Keys | ฝั่ง Client จัดการ Credentials เอง | Google Pay / Stored Auth Tokens |
| การควบคุมแบบเรียลไทม์ | Tethered Control (เฝ้าดูเบราว์เซอร์สด + Takeover ทันที) | ดูประวัติหลังทำเสร็จ / อนุมัติเป็นจุด ๆ | ควบคุมผ่าน Log และการตอบรับสิทธิ์ | อนุมัติผ่าน Consent Screens |
สรุปภาพรวม
จุดเด่นสำคัญที่ทำให้สถาปัตยกรรมของ Meta Muse มีความรัดกุมสูง คือการไม่พึ่งพาความปลอดภัยไว้ที่ตรรกะของ AI Model เพียงอย่างเดียว (Zero Trust in LLM Logic) แต่ใช้หลักการทางวิศวกรรมคอมพิวเตอร์ด้วยการสร้าง Muse Secure VM เพื่อกักบริเวณความเสียหาย และติดตั้ง Sentinel Agent ทำหน้าที่เป็นยามเฝ้าระวังภายนอกที่ไม่สามารถถูกหลอกลวงด้วย Prompt Injection บนหน้าเว็บได้ นวัตกรรมสถาปัตยกรรมนี้ถือเป็นบรรทัดฐานใหม่สำหรับการสร้างระบบ AI Agent ที่ได้รับความไว้วางใจในการทำงานแทนมนุษย์อย่างปลอดภัย