ปี 2026 ถือเป็นจุดเปลี่ยนครั้งใหญ่ที่สุดครั้งหนึ่งของวงการฮาร์ดแวร์โลก การแข่งขันไม่ได้วัดกันที่แค่ความเร็วนาฬิกา (Clock Speed) หรือจำนวนคอร์อีกต่อไป แต่เป็นการรบในระดับ "สถาปัตยกรรมเฉพาะทางเพื่อ AI" ตั้งแต่ดาต้าเซ็นเตอร์ระดับแร็ค ไปจนถึงชิปประหยัดพลังงานในคอมพิวเตอร์พกพา
ค่ายยักษ์ใหญ่อย่าง NVIDIA, Apple, Intel และ AMD ต่างเปิดตัวนวัตกรรมเปลี่ยนโลกที่แตกต่างกันอย่างสิ้นเชิง บทความนี้สรุปภาพรวม นวัตกรรมเด่น ข้อแตกต่าง และสิ่งที่จะถูกปลดล็อกในอนาคต
1. NVIDIA: สถาปัตยกรรม Vera Rubin - จากการขาย GPU สู่การสร้าง Agentic AI Factory
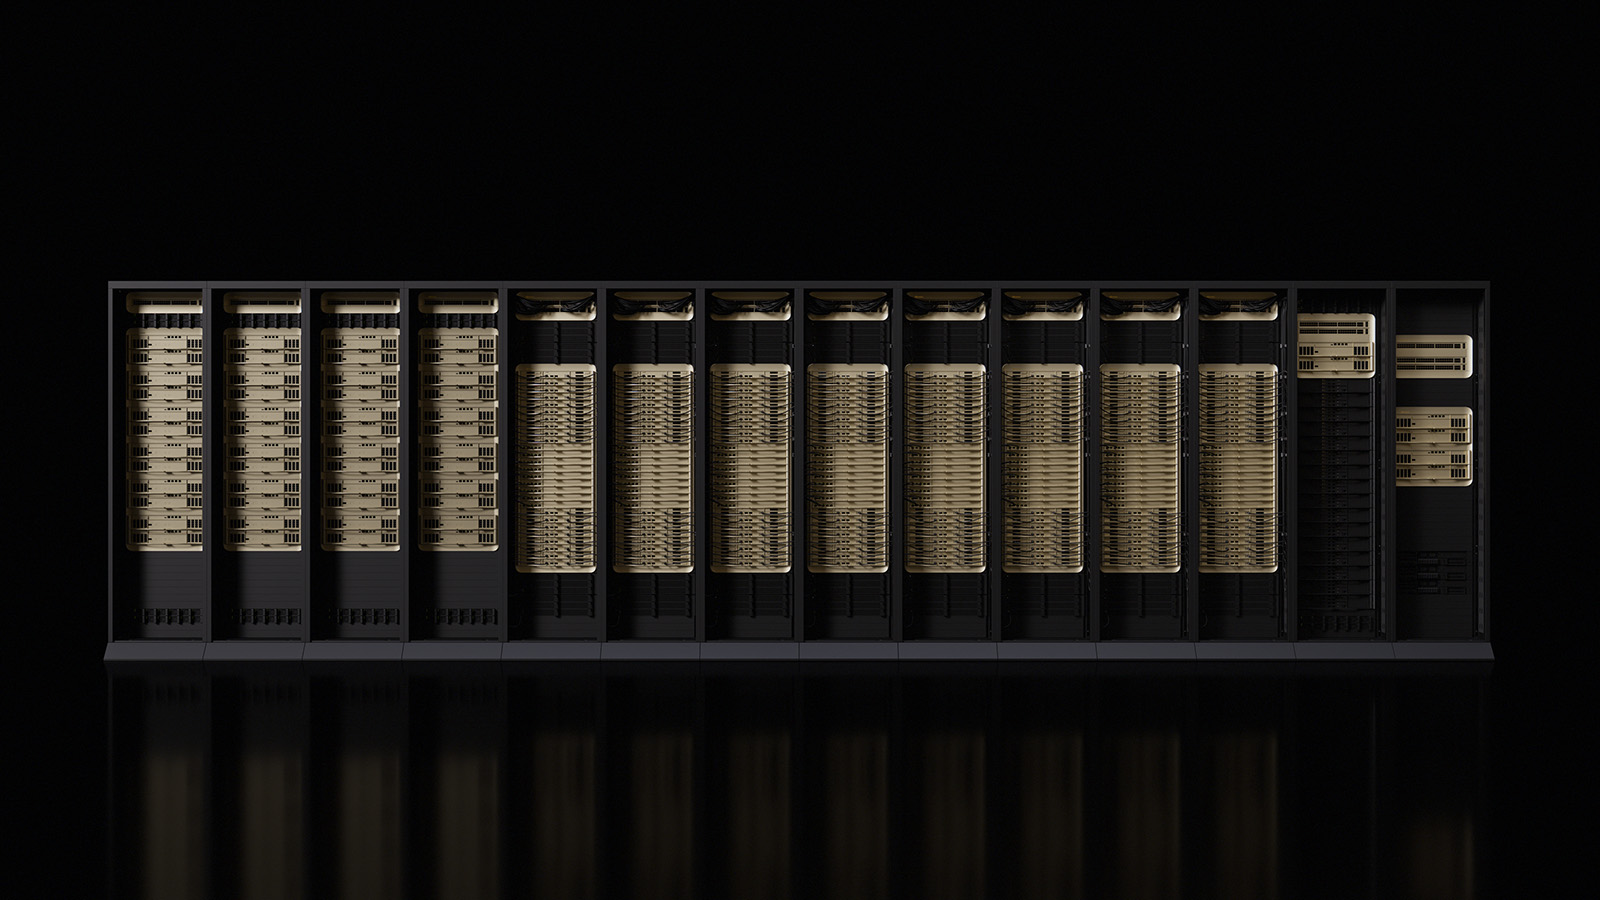
NVIDIA ก้าวข้ามคำว่า "ผู้ผลิตการ์ดจอ" ไปสู่การเป็นผู้สร้างโครงสร้างพื้นฐานระดับแร็คสเกล (Rack-scale Architecture) อย่างเต็มตัว ด้วยแพลตฟอร์ม Vera Rubin ถัดจากยุค Blackwell
จุดเด่นทางเทคโนโลยี
- ระบบ 6 ชิปผสานเป็นหนึ่งเดียว: Rubin ไม่ใช่แค่ GPU ใบเดียว แต่คือระบบแร็คที่รวม 6 องค์ประกอบหลัก ได้แก่ Vera CPU, Rubin GPU, NVLink 6 Switch, ConnectX-9 SuperNIC, BlueField-4 DPU และ Spectrum-6 Ethernet Switch เข้าด้วยกันเป็น "AI Factory" ที่สมบูรณ์
- หน่วยความจำ HBM4 & NVFP4: รองรับพลังประมวลผลสูงถึง 8 Exaflops (NVFP4) ต่อหนึ่งตู้แร็ค พร้อมแบนด์วิดท์ NVLink ระดับ 260 TB/s ต่อแร็ค NVL72 (แบนด์วิดท์มากกว่าอินเทอร์เน็ตทั้งโลก) ซึ่งเร็วกว่าสถาปัตยกรรมเดิมหลายเท่า
ต่างจาก Blackwell อย่างไร
Blackwell เน้นการขยายกำลังคำนวณในการเทรน LLM แบบดั้งเดิม แต่ Rubin ถูกออกแบบมาเพื่อ Agentic AI และ Test-time Scaling (การให้ AI ใช้เวลาคิดวิเคราะห์เชิงลึกก่อนตอบ) โดยเฉพาะ มีต้นทุนการรันโมเดล (Inference Token Cost) ต่ำกว่า Blackwell สูงสุดถึง 10 เท่า (และเทรน MoE ด้วย GPU น้อยกว่า 4 เท่า)
สิ่งที่ปลดล็อกในอนาคต
ปลดล็อกให้ AI เอเจนต์ทำงานซับซ้อนต่อเนื่องได้แบบ Real-time, รองรับ Context Window ระดับล้านโทเคนสำหรับการวิเคราะห์โค้ดและวิดีโอความยาวหลายชั่วโมง รวมถึงเป็นรากฐานของอุตสาหกรรมหุ่นยนต์และโมเดลโลกจำลอง (World Models)
2. Apple: M5 Family (M5, M5 Pro, M5 Max, M5 Ultra) - Neural Accelerator ในทุก GPU Core
Apple เปิดตัวชิป M5 เมื่อตุลาคม 2025 และต่อยอดด้วย M5 Max และ M5 Ultra ใน Mac Studio เมื่อสิงหาคม 2026 ซึ่งเป็น Mac ที่ทรงพลังที่สุดที่ Apple เคยสร้าง
จุดเด่นทางเทคโนโลยี
- Neural Accelerator ในทุก GPU Core: สถาปัตยกรรม GPU เจเนอเรชั่นถัดไปที่ฝังชุดคำนวณ AI เข้าไปในทุกคอร์ GPU ทำให้ AI Performance สูงกว่า M4 เกิน 4 เท่า และสูงกว่า M1 เกิน 6 เท่า
- M5 Max: 18-core CPU + up-to-40-core GPU + 128GB unified memory + 614 GB/s bandwidth (เพิ่ม 50% จากรุ่นก่อน) - AI performance 3.9x เร็วกว่า M4 Max
- M5 Ultra (ใหม่ใน Mac Studio): 36-core CPU + up-to-80-core GPU (most powerful Apple GPU ever) + 512GB unified memory + 1.2 TB/s bandwidth - AI compute 4.3x เหนือกว่า M3 Ultra และ 9.8x เหนือกว่า M1 Ultra
- Thunderbolt 5 + RDMA Clustering: เชื่อมต่อ 4 เครื่อง Mac Studio เข้าด้วยกันเพื่อสร้าง shared memory pool ขนาดมหึมา ทำให้ AI inference เร็วขึ้น 3x เท่า
สิ่งที่ปลดล็อกในอนาคต
รัน LLM ขนาดใหญ่ (frontier-class models) ทั้งหมดบนเครื่อง local โดยไม่ต้องนับ token หรือกังวลค่า cloud พร้อมความเป็นส่วนตัว 100% + framework ใหม่ Core AI และ MLX สำหรับ developers
3. Intel: Panther Lake (Core Ultra Series 3) - การคืนฟอร์มด้วยโหนด Intel 18A
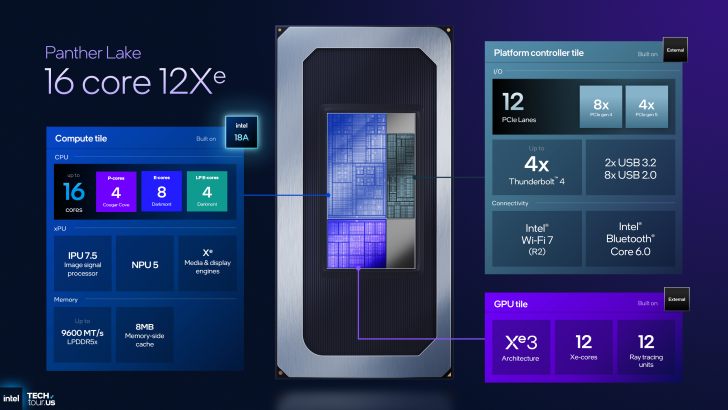
หลังจาก Lunar Lake และ Arrow Lake ที่ผลิตบน TSMC Intel กลับมาผลิตชิปด้วยโรงงานของตัวเองด้วยโหนด Intel 18A ผ่านสถาปัตยกรรม multi-tile SoC - เป็นครั้งแรกในรอบหลายปี
จุดเด่นทางเทคโนโลยี (จาก Intel + Ultrabook Review)
- Intel 18A + Multi-Tile SoC: CPU tile หลักผลิตบนโหนด 18A ของ Intel เอง ส่วน GPU tile (Arc B390, 12 Xe3 cores) ผลิตโดย TSMC - เป็นสถาปัตยกรรม chiplet ที่รวมข้อดีของทั้งสองโหนด
- CPU 16 cores (4P + 8E + 4LPE): ใช้ P-core Cougar Cove + E-core Darkmont พร้อม LPDDR5x-9600 และ ไม่มี Hyper-Threading (16 cores = 16 threads)
- Arc B390 GPU (12 Xe3 cores): การ์ดจอ iGPU ที่แรงกว่า Arc 140V ถึง 50% และเร็วกว่า Radeon 890M ของ AMD - พร้อม XeSS 3 multi-frame generation เป็นครั้งแรกนอกระบบ NVIDIA
- AI 180 TOPS (platform total): NPU5 (~50 TOPS) + GPU + CPU รวมกัน พร้อม Copilot+ PC certification
สถาปัตยกรรม 3 Die Configurations (จาก Wccftech Deep-Dive)
- Panther Lake 8C: 4 P-Cores (Cougar Cove) + 4 LP-E (Darkmont) + 4 Xe3 GPU cores - แทน Lunar Lake
- Panther Lake 16C: 4 P-Cores + 8 E-Cores + 4 LP-E + 4 Xe3 GPU - แทน Arrow Lake-H
- Panther Lake 16C 12Xe (flagship): เพิ่ม GPU เป็น 12 Xe3 cores พร้อม LPDDR5X-9600 (150+ GB/s) - GPU tile ผลิตบน TSMC N3E, compute tile บน Intel 18A
ประสิทธิภาพจริง (Intel official + Wccftech CES 2026)
- +60% multi-thread ที่ power เท่ากัน vs Core Ultra 9 288V (Lunar Lake)
- +82% gaming performance - Arc B390 vs AMD Radeon 890M (1080p, หลายเกม)
- +40% ประหยัดพลังงาน ที่ performance เท่ากัน (single-core)
- เร็วกว่า AMD Ryzen AI 9 HX 370 ในงาน multi-core (Cinebench 2024 MT)
- 16.5 ชั่วโมง Netflix streaming battery life (X7 358H)
สิ่งที่ปลดล็อกในอนาคต
เล่นเกม AAA แบบ native บนโน้ตบุ๊กบางเบา (Cyberpunk 2077 FHD: 54 fps native → 118 fps ด้วย XeSS 3) + รัน AI บนเครื่องด้วย NPU 5 รุ่นใหม่ + Thunderbolt 5 + Wi-Fi 7 - ทั้งหมดใน TDP 15-80W ที่แบตเตอรี่ยังอยู่ได้ทั้งวัน
4. AMD: Instinct MI350 Series - Open-Ecosystem Data Center Accelerator
AMD เจาะตลาด AI Data Center ด้วย Instinct MI350 Series (CDNA 4) ที่นำเสนอ "Leadership Performance, Cost Efficient, Fully Open-Source" เป็นทางเลือกที่แข็งแกร่งที่สุดต่อ NVIDIA ในปี 2026
จุดเด่นทางเทคโนโลยี (จาก AMD official)
- CDNA 4 + MXFP6/MXFP4: รองรับ datatypes ใหม่สำหรับ AI inference ที่เร็วกว่า FP16 แบบดั้งเดิม พร้อม AI Performance สูงสุด 10.1 PFLOPS (MXFP4/MXFP6) ต่อ GPU
- 288GB HBM3E + 8 TB/s: หน่วยความจำมหึมา (1.6x มากกว่า B200 ที่ 180GB) พร้อม bandwidth 8 TB/s ที่สูงกว่า B200 (7.7 TB/s)
- MI355X vs B200: AI performance FP6/MXFP6 สูงกว่า 2.2x, HPC FP64 สูงกว่า 2.1x (AMD Performance Labs)
- MI350P PCIe Card (ใหม่): การ์ดแบบ PCIe สำหรับ enterprise ที่ต้องการ deploy AI ใน rack เดิมโดยไม่ต้องเปลี่ยน infrastructure ทั้งหมด (144GB HBM3E, 4 TB/s, 128 CUs)
- Helios Rack-Scale (8-GPU Platform): รวม 8 GPU เข้าด้วยกันผ่าน 4th Gen Infinity Fabric รวม 2.3 TB HBM3E + 64 TB/s aggregate bandwidth + 80.5 PFLOPS
สถาปัตยกรรมเปิด (Open Ecosystem)
จุดแข็งหลักของ AMD คือ ROCm open-source software stack ที่ไม่มี licensing fee, รองรับ Day 0 สำหรับ frameworks หลัก (PyTorch, Hugging Face, Meta, OpenAI) และ AMD Inference Microservices (AIMs) ที่ deploy ได้ทันทีบน Kubernetes โดยไม่ต้อง vendor lock-in ทำให้ TCO ต่ำกว่า NVIDIA อย่างมีนัยสำคัญ
สิ่งที่ปลดล็อกในอนาคต
ลดต้นทุนการเทรนและ inference โมเดล AI ขนาดใหญ่ ให้ Open Source AI และบริษัทเทคโนโลยีที่ต้องการทางเลือกนอกจากระบบนิเวศปิดของ NVIDIA + enterprise AI ใน rack เดิม ผ่าน MI350P PCIe card ที่ไม่ต้องเปลี่ยน data center ทั้งหมด
ตารางเปรียบเทียบ
| ผู้ผลิต | ชิป/สถาปัตยกรรม | โหนด/สถาปัตยกรรม | นวัตกรรมเด่น | ปลดล็อกอะไร |
|---|---|---|---|---|
| NVIDIA | Vera Rubin (NVL72/144) | Rack-scale 6-chip, HBM4 | 8 Exaflops สำหรับ Agentic AI | AI Agent คิดลึกแบบ Real-time |
| Apple | M5 / Pro / Max | Dual-die 3nm Fusion | Neural Accelerator ทุก GPU Core | เทรน LLM + GenAI บนเครื่อง |
| Intel | Panther Lake (Core Ultra 3) | Intel 18A multi-tile SoC | 18A multi-tile + Arc B390 +180 TOPS AI | XeSS 3 gaming 118fps + Copilot+ PC |
| AMD | Instinct MI350 | CDNA 4 | FP4/FP8 สูงขึ้น 35 เท่า | MI350P PCIe + ROCm open-source ลดต้นทุน |
บทสรุป: ทิศทางของฮาร์ดแวร์ยุคถัดไป
ภาพรวมของฮาร์ดแวร์ล่าสุดชี้ให้เห็นชัดเจนว่า "ยุคของการวัดความแรงด้วย GHz ได้จบลงแล้ว" ทิศทางจากนี้ถูกขับเคลื่อนด้วย 3 ปัจจัยหลัก:
- AI-Specific Cores - ฮาร์ดแวร์ต้องมีชุดคำนวณเฉพาะทางฝังอยู่ในทุกส่วน ไม่ว่าจะเป็น CPU, GPU หรือแม้แต่ชิปเครือข่าย
- Memory-Centric Design - การขยายแบนด์วิดท์หน่วยความจำ (HBM4 / Unified Memory) กลายเป็นคอขวดที่สำคัญยิ่งกว่าความเร็วของตัวประมวลผล
- Efficiency over Raw Power - โหนดการผลิตใหม่อย่าง Intel 18A หรือ 3nm Fusion ของ Apple ไม่ได้เน้นแค่ทำให้ชิปแรงขึ้น แต่เน้นทำให้กินไฟน้อยลงเพื่อรัน AI ในอุปกรณ์ขนาดเล็กได้ยาวนาน
การพัฒนาฮาร์ดแวร์เหล่านี้คือรากฐานที่จะทำให้ AI ก้าวจาก "แชตบอตตอบคำถาม" ไปสู่ "ผู้ช่วยอัจฉริยะที่คิด ทำงาน และประมวลผลแทนมนุษย์ได้แบบไร้รอยต่อ" ทั้งบนคลาวด์และในอุปกรณ์พกพา
สำหรับองค์กรที่กำลังวางแผนลงทุน AI Infrastructure การเลือกฮาร์ดแวร์ที่เหมาะกับ Workload จริงสำคัญกว่าการไล่ล่าสเปกสูงสุด ทีม Devsign ปรึกษาและออกแบบ AI Infrastructure
Sources: NVIDIA Newsroom | Apple Newsroom | AMD Blog | PC Gamer | Ultrabook Review | Wccftech | Intel ตั้งแต่สำรวจ requirements จนถึงการเลือก GPU และวางระบบ Data Center ที่คุ้มค่าที่สุด